AI 번역 활용 가이드: 실수 없이 쓰는 법
AI 번역 도구를 효과적으로 활용하는 방법과 흔한 실수를 피하는 팁이에요.
읽기 5분AI 번역영어
영문 보도자료를 한국어로 올린 뒤 점수가 높게 나온 적이 있어요. 담당자는 “번역만 했다”고 했고, 파일을 열어 보니 번역기 결과 위에 또 한 번 문장 다듬기 도구를 돌린 흔적이 있었습니다. 최종본만 보면 그 두 층이 안 보여요. 점수는 층을 세지 않습니다.
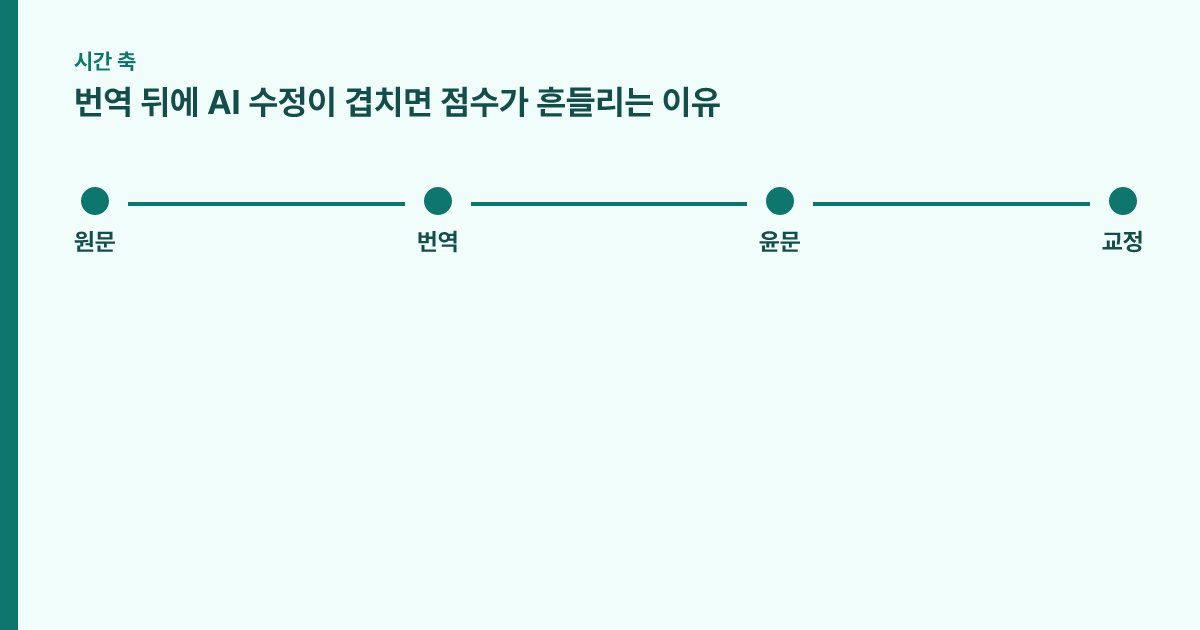
원문 → 사람 또는 기계 번역 → AI 윤문 → 사람 교정. 이 네 칸을 비워 두지 마세요. 어느 칸이 비었는지도 정보입니다. 원문이 있는데 번역 충실을 안 보고 점수부터 말하면, 직역체와 생성문을 같은 문제로 묶게 됩니다.
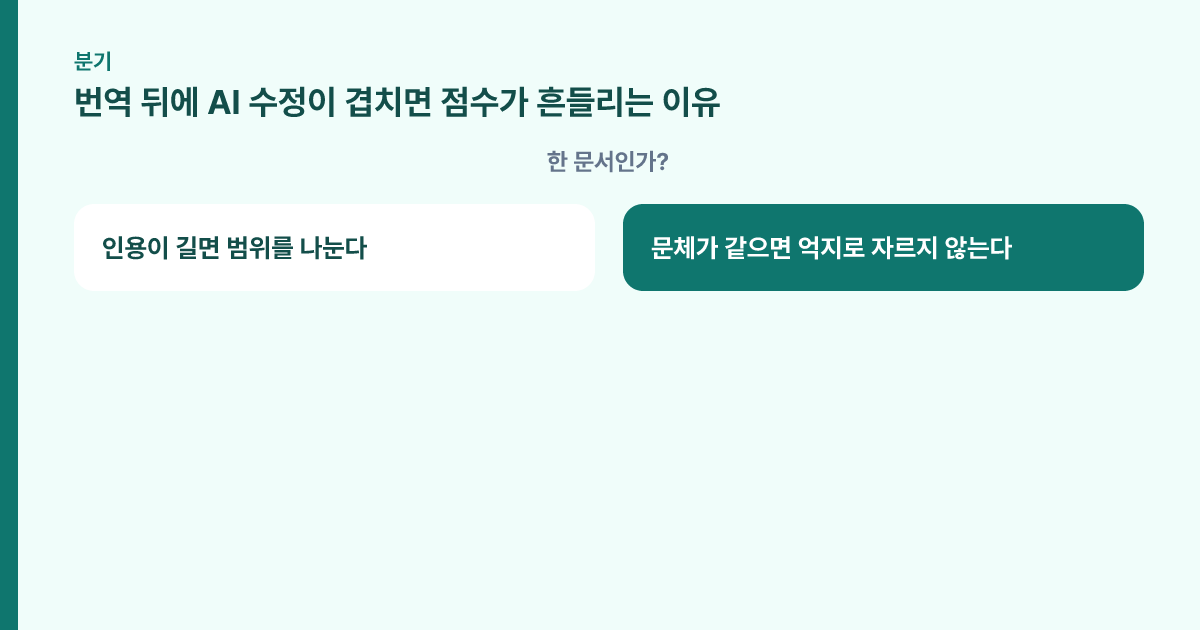
번역체는 어순이 균일하고 접속이 규칙적일 수 있어요. 생성문은 다른 이유로 반듯합니다. 최종 한국어만 넣고 “AI다”고 하면, 성실한 번역까지 의심하게 됩니다. 원문을 옆에 두고 문장 단위로 대응되는지를 먼저 봐요.
최종본은 항상 넣습니다. 독자가 읽는 글이거든요. 가능하면 윤문 직전과 직후를 비교합니다. 점수가 크게 움직였다면 그 층에서 문장이 다시 쓰인 겁니다. 움직임이 거의 없으면 윤문이 표현만 다듬었을 가능성이 커요. 어느 쪽이든 저자 이름 대신 층 이름을 적습니다.
원문을 보관할 수 없으면 최소한 언어와 번역 도구를 적어요. “영어 원문, DeepL 초벌, Claude로 윤문, 담당자 교정 40분.” 이 한 줄이 점수보다 재현에 쓸모 있습니다.
높은 점수가 번역기 사용을 증명하지 않아요. 낮은 점수가 사람 번역을 증명하지도 않아요. 층 기록과 원문 대조가 먼저입니다. 제가 실수했던 건 최종본 점수만 공유한 일이었어요. 번역 담당자가 생성 의심을 받고, 나중에 원문을 꺼내서야 대화가 끝났습니다. 그 한 시간이면 칸을 채우고도 남아요.
다국어 팀은 칸을 템플릿으로 박아 두세요. 원문 언어 / 번역 수단 / 윤문 여부 / 사람 교정 시간. Google도 AI 사용 자체가 아니라 유용한 콘텐츠인지를 본다고 말합니다. 작성 과정을 숨기지 않는 쪽이 나중에 설명이 쉽습니다. 검색 품질 안내의 출발점은 Google Search Essentials예요.
윤문 프롬프트에 “자연스럽게”만 넣고 돌리면 고유명사가 흔한 말로 바뀌기도 해요. 점수가 내려가도 사실이 틀어집니다. 그래서 윤문 전에 지키라는 고유명사 목록을 세 개만 적습니다. 도구 이름, 사람 이름, 수치. 이 세 개가 바뀌었으면 점수를 보지 말고 원문으로 돌아가요.
사람이 직접 한 번역인데 점수가 높다고 부끄러워하는 경우도 봤어요. 부끄러워할 일이 아닙니다. 반듯한 번역이 그런 신호를 만들 수 있다고 미리 말해 두면, 담당자가 문장을 일부러 어색하게 만들지 않습니다. 어색한 번역은 독자에게 더 비쌉니다.
층 기록을 남기기 싫다는 팀은 보통 책임이 섞여 있어서예요. 번역은 A, 윤문은 B, 발행은 C. 한 점수가 세 사람을 동시에 의심합니다. 칸을 나누면 의심도 나뉩니다. 그게 불편해 보여도, 한 방에 세 사람을 의심하는 회의보다는 짧아요.
제가 번역 층을 건너뛰고 윤문본만 본 날, 고유명사 하나가 보통명사로 바뀐 걸 나중에서야 알았습니다. 점수는 오히려 낮았어요. 낮은 점수에 안심하다 사실이 틀어진 케이스입니다. 그래서 지금은 점수 방향과 사실 확인을 같은 문장에 넣지 않습니다. 사실은 원문 대조, 신호는 별도 줄. 두 줄이 있어야 층이 보입니다. 층을 숨긴 채 점수만 공유하면 번역 담당자가 생성 의심을 혼자 받습니다. 그 고립이 품질을 떨어뜨려요. 칸을 공개하는 편이 사람 편이기도 합니다.
그라운드코드
AI 보조 작성 · 최종 검토 2026-09-07